


Той, хто не показує карт: як Ataraxos навчився блефувати краще за чемпіона світу
У грі, де половина інформації прихована, система Ataraxos вперше обіграла людину, яка присвятила життя мистецтву вводити в оману.
Дошка, яку бачиш лише наполовину
Шахи чесні. Кожна фігура лежить на столі, кожен хід можна прорахувати, а помилка завжди є наслідком недогляду або браку глибини аналізу. Саме тому комп'ютери так давно й так впевнено перемагають людей у цій грі.
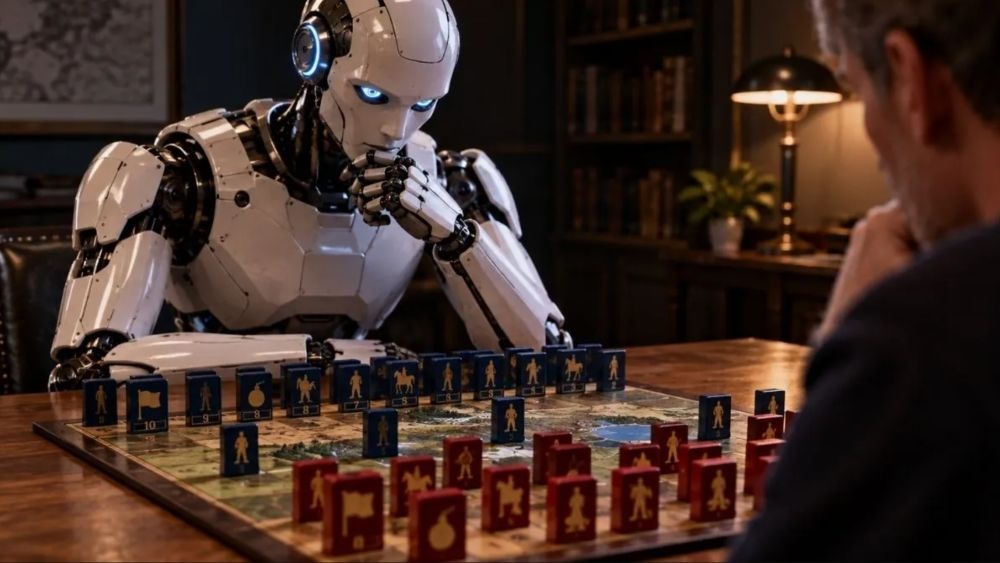
У Stratego все інакше. На перший погляд це схоже на військові шахи. Двоє гравців розставляють по 40 фігур: солдатів різних рангів, бомби й прапор, а мета в тому, щоб прорватися крізь ряди супротивника й захопити його прапор. Різниця в тому, що кожен бачить лише свої фігури. Хто саме стоїть навпроти (рядовий, офіцер чи смертельно небезпечна бомба), з'ясовується лише в момент зіткнення.
Тож тут мало вміти рахувати. Доводиться читати суперника: з яких фігур він ходить, що береже, де обережний, а де раптом іде на ризик. І водночас треба видавати про себе якомога менше правди. Слабку фігуру можна вести так, ніби вона безцінна. Вирішальну можна змусити поводитися непримітно, майже непомітно. Кожен хід одночасно здобуває інформацію й відправляє дезінформацію.
Недарма ігри з прихованими даними роками лишалися для штучного інтелекту значно складнішим випробуванням, ніж шахи чи го.
Двадцять партій, які могли закінчитися інакше
Тепер цей бастіон упав. Система Ataraxos, описана в новому дослідженні вчених Массачусетського технологічного інституту, Університету Карнегі-Меллона, Нью-Йоркського університету та Стенфорду, зіграла серію з 20 партій проти Піма Німейєра. Це чотириразовий чемпіон світу, п'ятнадцятиразовий чемпіон Нідерландів, який понад 600 тижнів очолював світовий рейтинг. Одна з найтитулованіших постатей в історії Stratego.
Рахунок: 15 перемог, одна поразка, чотири нічиї.
Важливо, що це був не короткий показовий матч, де людині можна списати невдачу на неуважність. Німейєр розумів природу експерименту. Він знав, що система не підлаштовуватиметься під його особистий стиль, і мав двадцять партій, щоб знайти повторювану слабину й спробувати на ній зіграти. Двадцять спроб розгадати супротивника, який не показує карт. Результат свідчить, що розгадати його було непросто.
Як навчити машину сумніватися
Основа навчання знайома з попередніх гучних успіхів ШІ в іграх: самостійна гра. Ataraxos зіграв величезну кількість партій проти самого себе й так вибудував базову стратегію. Йому не давали бази людських партій і не просили копіювати майстрів. Він доходив усього сам.
Новизна не в цьому, а в тому, що відбувається далі. Систему розділили на кілька спеціалізованих частин:
-
одна мережа вчиться розставляти фігури на початку гри;
-
друга відповідає за керування ними в ході партії;
-
третя в реальному часі намагається збагнути, що ховається на іншому боці дошки.
Ось де починається найцікавіше. Перш ніж походити, Ataraxos не вгадує одну-єдину позицію супротивника. Він генерує набір найімовірніших розкладів прихованих фігур, програє свої можливі ходи в кожному з таких сценаріїв і лише тоді обирає дію. Інакше кажучи, він тримає в голові не одну версію реальності, а кілька, і зважує їх.
Звідси здатність змінювати оцінку просто під час партії. Якщо суперник кілька ходів поспіль поводиться так, ніби певна фігура надзвичайно цінна, модель підвищує ймовірність, що так воно і є. Проте вона так само може дійти й іншого висновку: людина намагається її обдурити.
Тут і лежить інтрига всієї історії. Машина не просто рахує. Вона підозрює.
Блеф без підручника
Автори дослідження порівняли манеру гри системи з поведінкою людей, і виявилося, що Ataraxos не просто копіює людський стиль. Деякі поширені людські блефи він використовує рідше, зате в інших ситуаціях ризикує там, де досвідчені гравці зазвичай утримуються. Він може вести пішака так, що його ранг важко розпізнати, і довго тримати юнітів у запасі, тоді як люди часто жертвують ними раніше. А коли програє, стає агресивнішим, і супернику складніше реалізувати свою перевагу.
Це не механічне наслідування. Це власний, вироблений у мільйонах партій з самим собою почерк, який чемпіон світу не зміг розкусити.
DeepNash і ціна успіху
Найвиразніше цей результат видно на тлі попередника. У 2022 році DeepMind представила DeepNash, на той час найбільший крок до оволодіння Stratego штучним інтелектом. Та модель дійшла до рівня дуже сильних гравців-людей. Ataraxos виявився значно потужнішим і при цьому набагато дешевшим у навчанні.
За даними команди, знадобилося менш як одна сота від кількості навчальних прикладів, використаних для DeepNash, і менш як одна тридцята від кількості партій самостійної гри. Загальну вартість навчання автори оцінюють у кілька тисяч доларів, тоді як попередні промислові експерименти зі Stratego коштували значно більше.
Це ключовий момент: перед нами не перемога грубої сили. Йдеться не про те, що додали ще процесорів і ще раз збільшили масштаб задачі. Дослідники придумали, як навчати модель ефективніше в іграх із величезним обсягом прихованої інформації. А розмах цієї задачі приголомшує: кількість можливих початкових розстановок у Stratego перевищує 10⁶⁶, і модель не знає, з якою з них має справу.
Не лише Stratego
Щоб довести, що знайдений підхід не вузькоспеціалізований трюк, автори перевірили схожі механізми на інших іграх. Ataraxos показав надлюдський рівень у швидшому варіанті Stratego, встановив нові рекорди в кооперативній грі Hanabi і перевершив попередні досягнення ШІ в китайській карточній грі Dou Dizhu. У кожній із них інформація розподіляється між гравцями по-різному: десь вона прихована від суперників, десь доводиться координуватися з партнером, який теж бачить не все.
Від Цицерона до мовчазного блефу
Ігри з прихованою інформацією давно стали наступним полем змагання людини й машини. Раніше Cicero від Meta грав у Diplomacy, де треба розмовляти з іншими гравцями, будувати союзи й передбачати наміри. Stratego перевіряє іншу навичку. Тут немає ні переговорів, ні слів. Інформацію можна видобути лише з ходів супротивника, пам'ятаючи, що будь-який із них може бути спробою вас обдурити. Це блеф у чистому вигляді, без жодного слова.
І цього разу машині не дали повної картини, яку лишалося просто прораховувати дедалі швидше. Їй довелося навчитися ухвалювати правильні рішення, навіть коли частини відповідей вона просто не знає.
Що це означає за межами дошки
Дослідники називають переговори, кібербезпеку й планування дій прикладами задач, що теж вимагають рішень за неповного знання. Втім, до таких застосувань ще далеко: у настільної гри чіткі правила, а в реальності їх немає. Це чесне застереження, і його варто пам'ятати.
Але є й інша сторона. Ще нещодавно здавалося, що хоч щось у людини машині не віддати: інтуїція, вміння читати іншого, ризик, блеф. Те, що відбувається, коли відповідей не вистачає, і є територією людської переваги. Перемога над майстром Stratego показує, що сама по собі прихована інформація вже не є надійним способом повернути цю перевагу.
Залишається питання, на яке поки ніхто не має відповіді: де проходить наступна межа?


